2026世界机器人大会现场,具身智能再次成为聚光灯下的主角。从精密抓取、柔性交互到连续作业,越来越多机器人正在走出实验室、进入真实场景。与几年前业界更关注模型参数和本体性能不同,今年更多企业把真实落地案例和场景适配摆到台前。当机器人走出实验室、走进工厂与家庭,决定它能否真正“站稳脚跟”的关键究竟是什么?
“模型决定机器人能不能学,数据则决定机器人最终能学会什么。”行知启航CTO耿赛猛接受采访时表示。在他看来,具身智能行业正在从“模型驱动”向“数据驱动”转变。
竞争焦点从模型转向数据
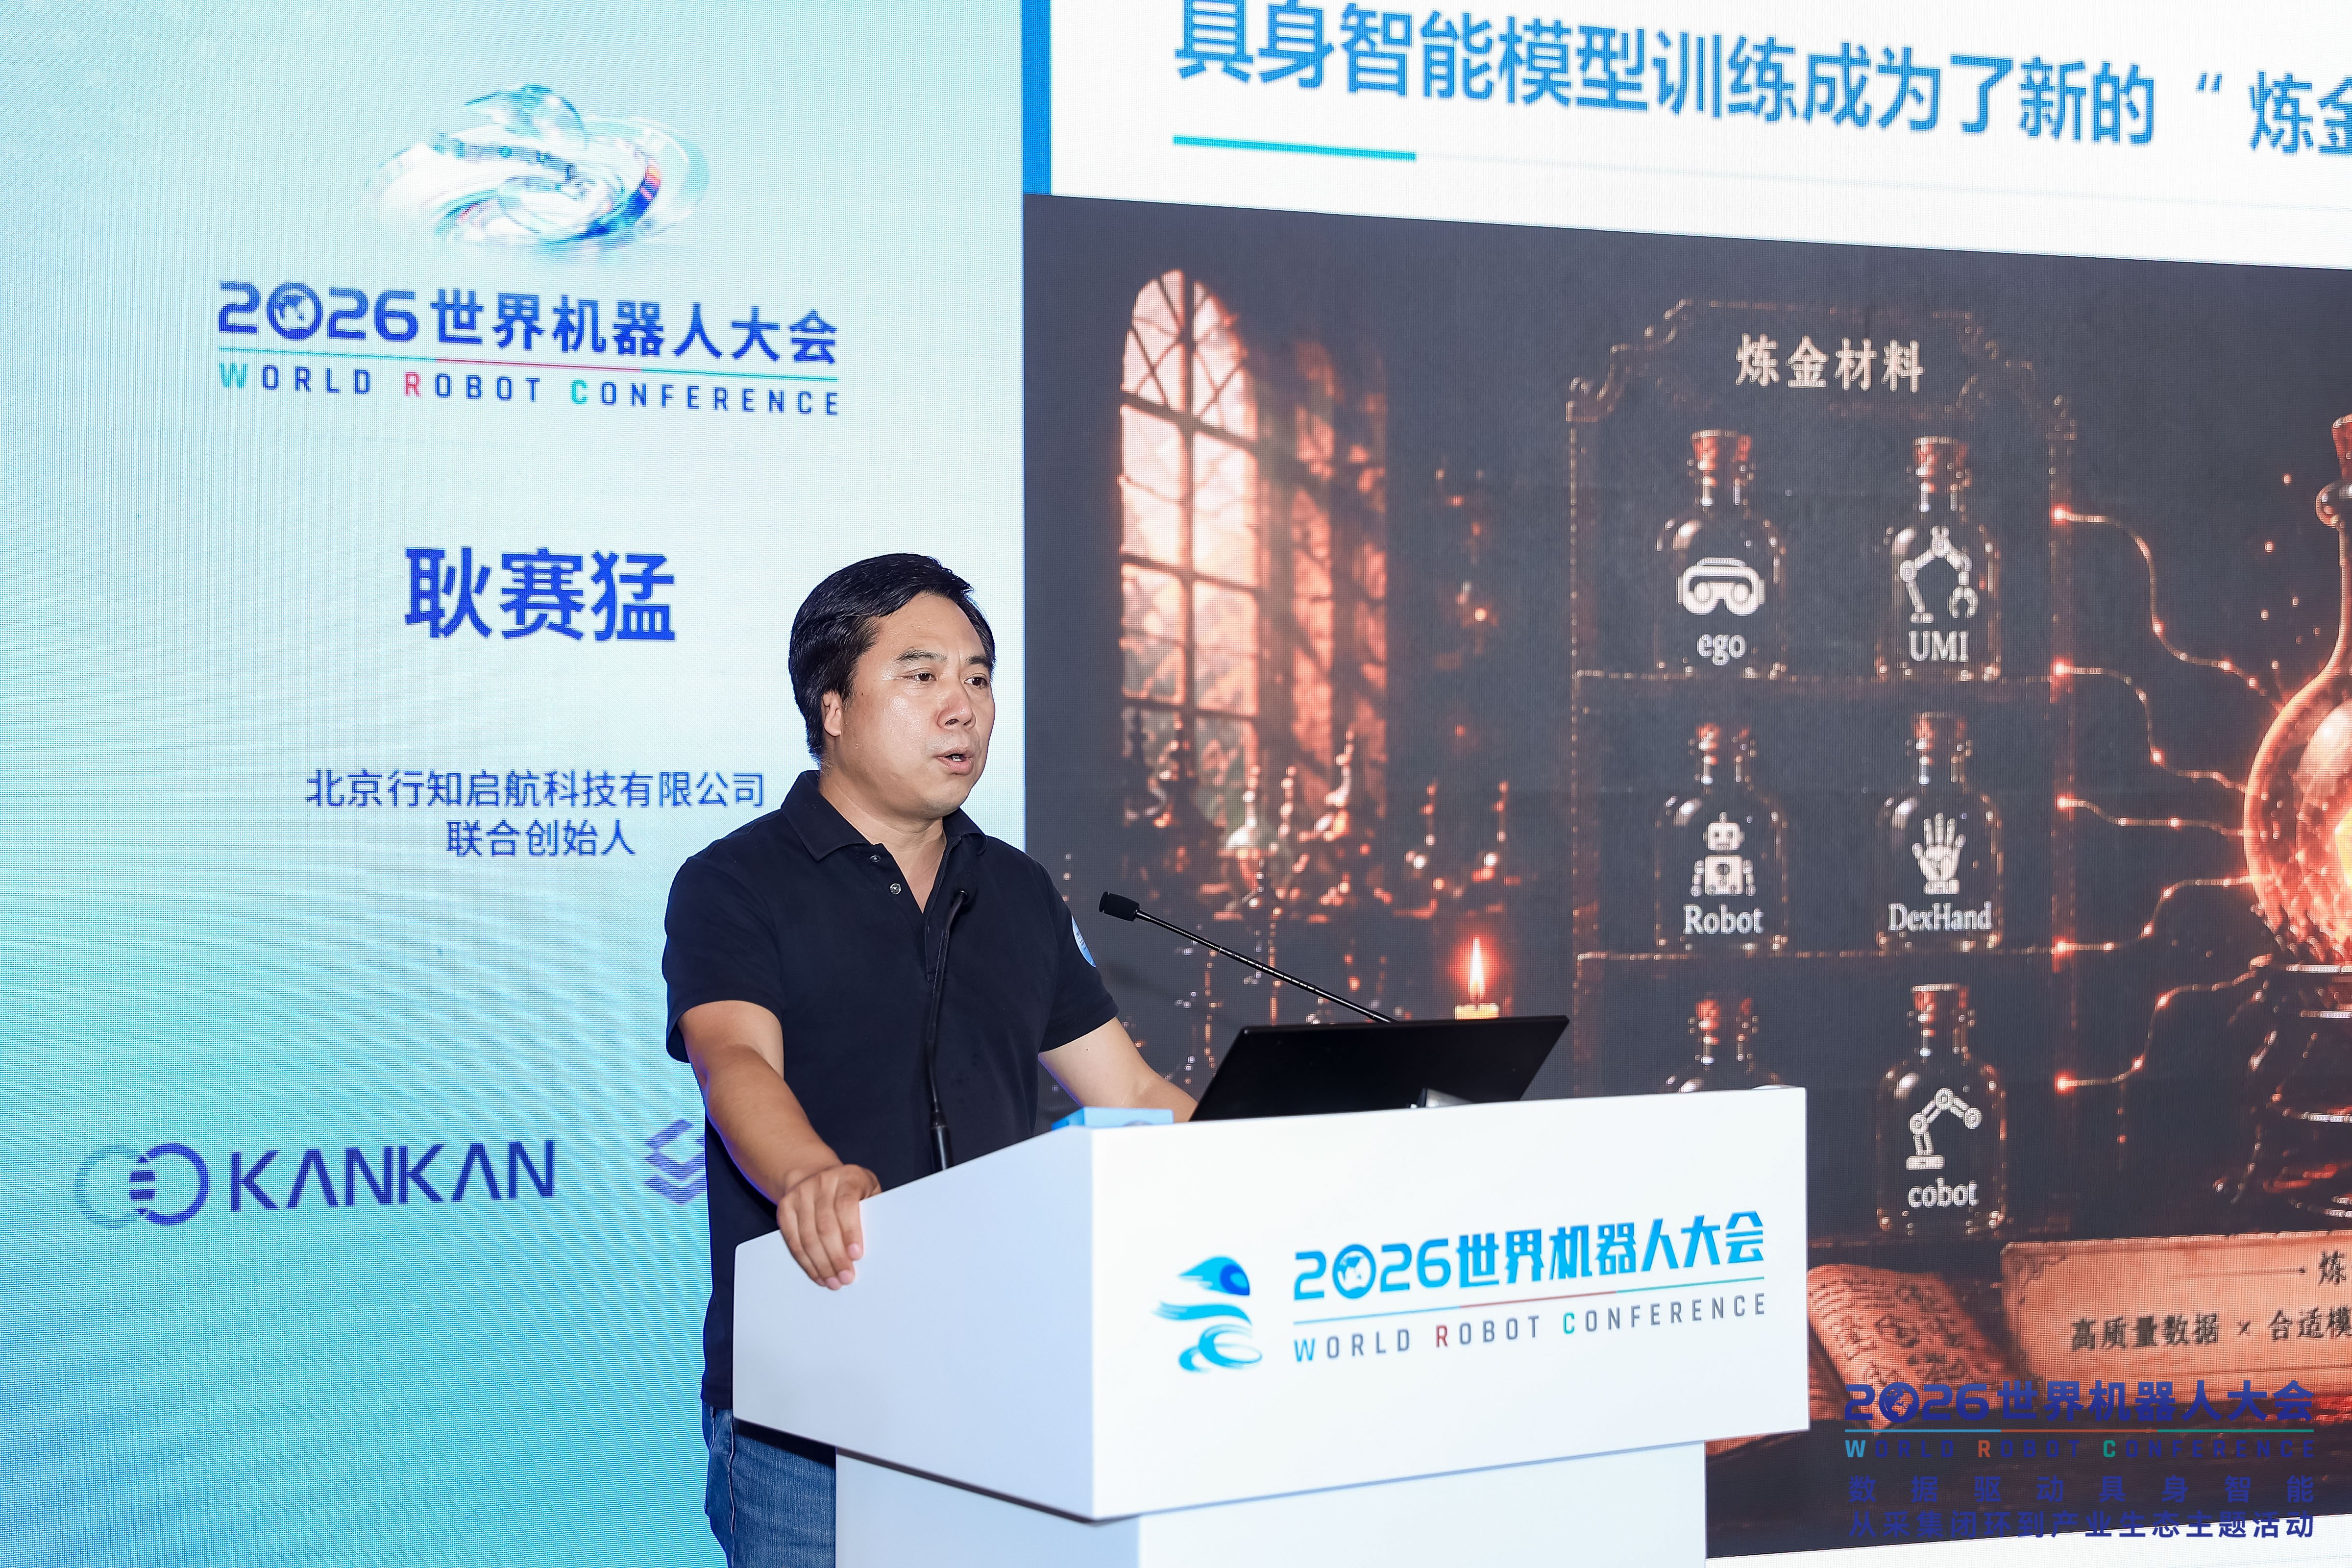
耿赛猛将当前的具身智能模型训练形象地比作一场“现代炼金术”,模型像配方,算力像炉火,数据则是原料。具身智能的涌现需要高质量数据、合适模型和有效训练的共同作用,行业目前还处在快速探索最佳配方的阶段。
当前行业技术路线纷呈,VLA(视觉 - 语言 - 动作模型)、VLM(视觉语言模型)、World Model(世界模型)、Diffusion Policy(扩散策略)各有拥趸,数据端同样多元,真机、遥操作、仿真、Ego(第一人称视角)、UMI(通用操作接口)不一而足。“大家都在尝试什么模型、什么数据、什么训练方式组合在一起,能够产生更好的机器人能力。”耿赛猛说。
耿赛猛认为,模型架构会快速传播,算力可以采购,唯独高质量真实世界数据难以在短时间内复制。机器人进入真实世界后,需要理解接触、摩擦、遮挡、光照变化、物体差异,以及大量长尾场景,这些仅靠互联网数据无法获得。“具身智能的瓶颈正在越来越多地从模型转向数据。”耿赛猛说,“这并非简单比拼‘谁有更多数量’,真正竞争的是持续获得高质量、高多样性、高物理保真且能真正转化为模型能力的数据。”
高质量真实数据从哪里来?这是行知启航首先需要解决的问题。在具身智能领域,不同类型的数据不能一概而论,耿赛猛将当前具身智能数据画成了一座“金字塔”,底层是通用多模态数据,规模最大、语义丰富,但与机器人动作和物理交互距离最远;往上依次是仿真数据、人类Ego数据、Ego+UMI组合数据;金字塔顶端则是真机数据,物理保真度最高,但采集成本也最为昂贵。
“越往上,数据越‘真’,也越贵;越往下,数据越容易规模化,但离机器人真实的物理交互越远。”耿赛猛解释,“所以不能简单地说哪一种数据最好,真正优秀的数据集应该在质量、多样性、可复用性和物理保真之间找到平衡。”
因此,行知启航选择了一条“多源数据协同”的路线。目前,行知启航已在运营北京、苏州、青岛等7地的训练场,并布局21处卫星采集点,形成分布式的具身智能数据生产网络。其中,训练场重点承担机器人真机数据生产,通过部署不同机器人本体、搭建多样化物理场景,获得高物理保真的机器人操作数据;卫星采集点则通过更加轻量化、便携化的设备,将Ego、UMI等数据采集延伸到更加丰富的真实环境。
这种布局背后,不仅仅是扩大产能。“如果机器人永远只在同一个实验室、同一套桌椅、同一种光照下训练,它很可能只是记住了这个环境,而不是真正学会了任务。”耿赛猛说。不同地域、不同场景、不同物体、不同机器人、不同操作人员形成的数据差异,恰恰是机器人提升泛化能力所需要的“生活经验”。
因此,行知启航建设全国采集网络的一个重要目标,就是不断扩大真实世界的数据分布。让机器人从“记住一个场景”,走向“学会一类任务”。
成立首年,行知启航累计完成超4万小时真机数据、140万条Ego-UMI任务数据,数据生产覆盖10+主流机器人本体构型。这些数字背后,是行知启航正在尝试建立的一种新的具身数据生产方式:把过去分散的、项目制的数据采集,逐步变成可以跨区域调度、标准化生产和规模化交付的数据基础设施。
机器人数据,不一定只能由机器人生产。但仅仅扩大真机采集规模,还不足以解决具身智能未来的数据需求。“如果未来每产生一条训练数据,都必须占用一台机器人,那么整个行业的数据规模最终一定受制于机器人数量。”耿赛猛认为,具身智能下一阶段一个非常重要的方向,是如何将人类真实生活和生产中的行为,转换成机器人新的“教材”。
人每天都在开门、整理、拿取、清洁、装配、搬运。这些看似普通的动作,其实包含着丰富的物理世界知识。为此,行知启航正在布局从Ego、Ego+UMI到Ego+SLAM、Ego+DexHand的数据技术路线。简单来说,就是让数据从最初的“看到人做了什么”,逐步升级为“理解人在哪里、手怎么运动、物体在哪里、人与物体怎样交互”,未来进一步加入手部关节和触觉等信息。
耿赛猛认为:“未来决定具身数据规模上限的,可能不是机器人保有量,而是我们能以多高的效率把人类行为转化成机器人可学习的数据。”如果这一技术路线进一步成熟,具身智能数据的生产逻辑也可能随之改变。从“机器人生产机器人数据”,逐步走向“机器人数据+人类行为数据+仿真数据”共同构成训练基础。
数据只是中间产品,机器人能力才是最终产品
规模之外,行知启航正在解决的第二个问题是:怎样证明一批数据真的有用?具身智能数据成本高昂且需求量大,而数据量大,并不意味着数据价值高。
耿赛猛认为,判断一批数据是不是“有效数据”,不能只看它是否完整、标注是否准确、格式是否合规,最终还要看它能不能真正让机器人模型的能力得到提升,这可以从三个标准来判断:“第一,数据合格不等于数据有效。第二,判断数据价值的最终标准是它能否带来模型能力提升。第三,数据质量的终极评价标准不在数据端,而在模型端。” 换句话说,完整、准确只是“及格线”,关键要看机器人有没有因为这些数据真正变得更强。
为此,行知启航没有把业务停留在传统的采集、清洗和标注环节,而是自主构建了覆盖生产管理、数据采集、模型训练与测评、中试验证等环节的平台体系。从订单和任务开始,数据进入采集、处理和质检环节,再进入模型训练和标准任务评测;模型在哪里失败、为什么失败,又会反向形成新的数据需求,并调度采集节点进行定向补采。由此形成一个不断循环的数据闭环:数据生产—模型训练—真机评测—失败分析—定向补采—复训复测。
随着行知启航越来越深入模型训练和真实场景,公司对自身业务边界的理解也在发生变化。传统数据服务通常以数据交付为终点,但对于行知启航来说,这只是走完了第一步。但机器人进入真实世界之后,第一轮训练往往只是开始。模型经过部署,会暴露新的失败场景;失败产生新的数据需求;新数据又进入下一轮训练。因此,行知启航在承接客户当前数据需求时,也开始提前规划未来2至3轮的数据生产能力,使数据生产围绕模型能力演进持续迭代。
“客户真正需要的不是一百万条轨迹,而是机器人真正学会一个技能。”耿赛猛说。这句话也代表着行知启航正在尝试完成的一次业务升级,定位为具身智能数据全栈解决方案的提供者,从交付数据,进一步走向支撑机器人能力交付。
耿赛猛认为具身智能行业正在从“比Demo”逐渐走向“比交付”,从“比模型参数”走向“比真实场景能力”。当模型与本体能力逐渐成熟,真正拉开差距的可能是三件事:持续获得真实世界高质量数据的能力;建立数据—模型—部署—评测闭环的能力;让机器人进入足够多真实场景、再通过场景反哺数据的能力。
“具身智能不会只是一场模型竞赛,也不会只是一场机器人硬件竞赛,它最终是一场真实世界学习效率的竞赛。”耿赛猛说。从实验室里的“炼金术”到“数据工业化”的体系化推进,具身智能的故事正在翻开新的一页。“数据”正是这一页的关键词之一。(文/王岩)